Prüfen Sie zuerst die Canonical-Tags, Redirects und Noindex-Signale Ihrer wichtigsten Seiten, dazu den Google Search Console Bericht zu doppelten Seiten. Duplicate Content in WordPress entsteht meist durch URL-Parameter, Protokoll- oder www-Varianten und fehlerhafte Canonical-Angaben. Diese Ursachen lassen sich mit einem strukturierten Audit zuverlässig aufspüren und beheben, bevor sie Ranking-Signale verwässern.
Kurz gesagt:
- Ändern Sie eine URL dauerhaft, leiten Sie mit Statuscode 301 weiter; legitime Varianten verweisen auf die bevorzugte Adresse, dünne Filterseiten schließen Sie vom Index aus.
- Eine Sperre in der robots.txt verhindert, dass Suchmaschinen kanonische Verweise oder Indexierungssperren auslesen; Statuscode, interne Verweise und Sitemap müssen zur bevorzugten URL passen.
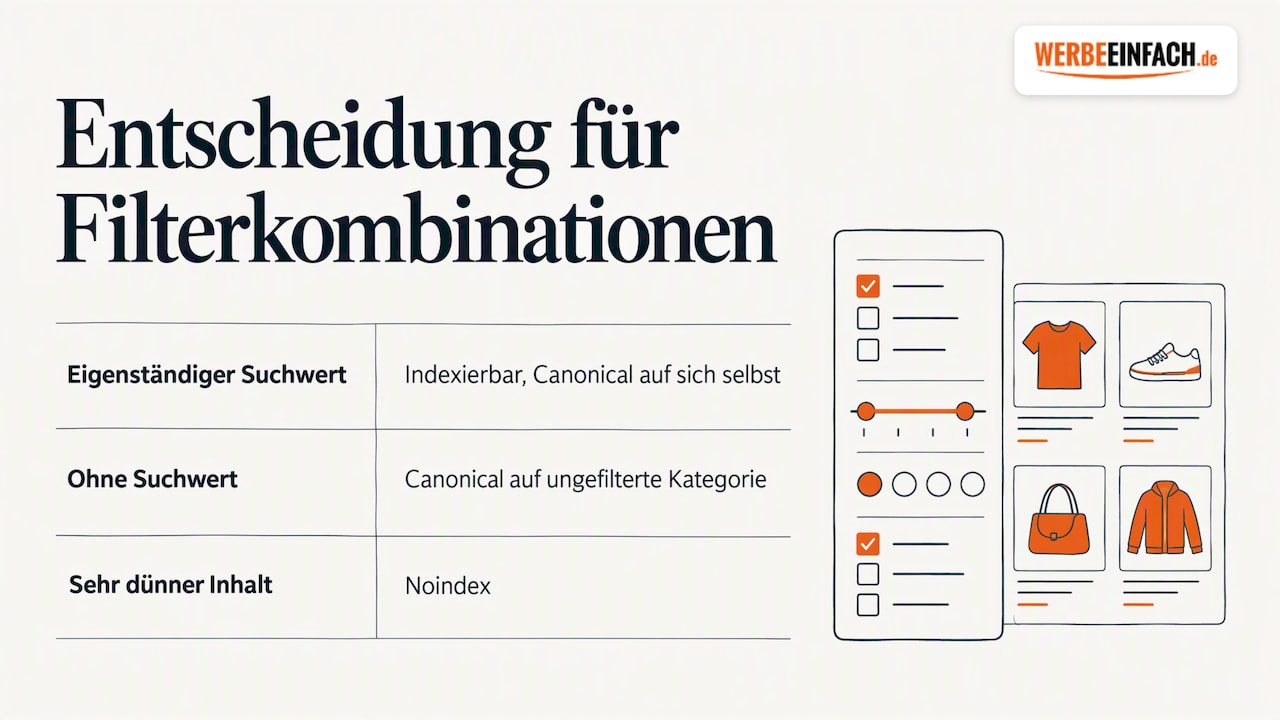
- In Shops indexieren Sie Filterkombinationen nur bei eigenständigem Suchwert; seltene Varianten verweisen auf die ungefilterte Kategorie, und feste Reihenfolgen der Parameter begrenzen doppelte Adressen.
- Nach jeder Korrektur beobachten Sie mehrere Wochen lang die Neuindexierung und prüfen stichprobenartig, ob Google die gewünschte URL als maßgeblich übernimmt.
Inhaltsverzeichnis
- Welche technischen Ursachen stecken hinter doppelten Inhalten?
- Wann ist Canonical, Redirect oder Noindex die richtige Wahl?
- Audit-Checkliste: So prüfen Sie Ihre Website Schritt für Schritt
- WordPress-konkrete Umsetzung: Permalinks, Plugins und Einstellungen
- Wie wir Sie bei Audit, Fix und laufender Wartung unterstützen
- Optimierung von Mehrsprachigkeit und hreflang-Tags in WordPress
- Welche Risiken entstehen durch häufige Fehleinstellungen?
- Besondere Herausforderungen bei dynamisch generierten Inhalten
- Kurzangebot: Duplicate-Content-Check und Wartungspaket
- FAQ
- Quellen
Welche technischen Ursachen stecken hinter doppelten Inhalten?
Duplicate Content entsteht in WordPress selten durch Absicht. Meistens produziert die Website-Struktur selbst mehrere URLs für denselben Inhalt, ohne dass jemand es bemerkt. Laut SISTRIX zählen URL-Parameter, Protokoll- und www-Varianten sowie fehlende oder falsche Canonical-Angaben zu den häufigsten Ursachen.
Folgende technische Quellen tauchen in der Praxis am häufigsten auf:
- URL-Parameter wie Filter, Sortierungen, UTM-Tags oder Session-IDs erzeugen zahlreiche Varianten derselben Seite.
- Http und https, www und non-www sowie Trailing Slashes oder Groß- und Kleinschreibung führen zu mehreren erreichbaren URLs für einen Inhalt.
- Kategorie- und Tag-Archive, Paginierung sowie PDF-Dokumente erzeugen oft unbeabsichtigte Duplikate.
- Fehlende, falsche oder widersprüchliche Canonical-Tags verstärken das Problem zusätzlich.
Besonders Parameter sind tückisch, weil sie von Marketing-Tools oder internen Suchfunktionen automatisch erzeugt werden. SISTRIX empfiehlt, Parameter wenn möglich zu vermeiden oder zumindest in einer festen Reihenfolge zu generieren, damit die Zahl der Kombinationen begrenzt bleibt. Auch PDFs verdienen Aufmerksamkeit: Sie lassen sich nicht über ein HTML-Canonical steuern, sondern benötigen einen eigenen Umgang über HTTP-Header.
Wann ist Canonical, Redirect oder Noindex die richtige Wahl?
Die drei Werkzeuge lösen unterschiedliche Probleme, und sie werden in der Praxis häufig verwechselt. Ein 301-Redirect leitet eine URL dauerhaft auf eine andere um und eignet sich für endgültige Adressänderungen, etwa nach einem Relaunch. Ein Canonical-Tag signalisiert Google, welche von mehreren ähnlichen Varianten als Referenz gelten soll, ohne die anderen URLs unerreichbar zu machen. Noindex entzieht eine Seite komplett dem Index, was sich für dünne Filter- oder interne Suchergebnisseiten anbietet.
Die Entscheidung folgt meist diesem Muster:
- Hat sich eine URL dauerhaft geändert? Dann gehört hierhin ein 301-Redirect, keine Canonical-Lösung.
- Existieren mehrere legitime Varianten desselben Inhalts, etwa durch Parameter? Dann setzen Sie ein Canonical auf die bevorzugte Version.
- Ist eine Seite inhaltlich zu dünn oder bietet keinen eigenen Mehrwert, etwa eine Filterkombination mit null Treffern? Dann ist Noindex die richtige Wahl.
Ein verbreiteter Irrtum betrifft die robots.txt: Sie ersetzt kein Noindex und kein Canonical, denn eine blockierte Seite kann vom Crawler gar nicht erst auf ihre Meta-Angaben geprüft werden. Genauso wenig dürfen Canonical und Noindex gleichzeitig auf dieselbe Seite gesetzt werden, das erzeugt ein widersprüchliches Signal, das Google oft schlicht ignoriert. Laut Seitenreport müssen Statuscodes, interne Links und Sitemap-Einträge immer zur Canonical-Angabe passen, sonst verliert das Tag seine Wirkung.
Profi-Tipp: Prüfen Sie nach jeder Änderung, ob Statuscode, Canonical-Ziel und interne Verlinkung dieselbe URL favorisieren, denn ein einziges widersprüchliches Signal reicht aus, um die ganze Korrektur zu entwerten.
Audit-Checkliste: So prüfen Sie Ihre Website Schritt für Schritt
Ein strukturiertes Vorgehen verhindert, dass Sie Symptome statt Ursachen behandeln. Die folgende Reihenfolge hat sich in der Praxis bewährt, unabhängig davon, ob Sie das Audit selbst durchführen oder einem Dienstleister übergeben.
- Öffnen Sie in der Google Search Console den Bericht zu Seiten, die als Duplikat ohne vom Nutzer festgelegte kanonische Version eingestuft wurden, und notieren Sie betroffene URL-Muster.
- Prüfen Sie Server- und Crawl-Logs auf auffällige Crawling-Muster sowie auf Weiterleitungsketten, die unnötig viele Sprünge enthalten.
- Kontrollieren Sie den Quellcode zentraler Seiten: Existiert genau ein Canonical-Tag, und führt dessen Ziel-URL zu einem indexierbaren Status 200, nicht zu einer 404 oder einer Soft-404?
- Analysieren Sie, welche URL-Parameter tatsächlich neue Inhalte erzeugen und welche nur technische Varianten sind, und behandeln Sie beide Gruppen unterschiedlich.
- Beobachten Sie nach jeder Korrektur die Neuindexierung über mehrere Wochen und prüfen Sie Stichproben, um sicherzugehen, dass Google die gewünschte Version übernimmt.
Die richtige Reihenfolge dabei: erst Statuscode, dann Redirect-Kette, dann Canonical- und Indexierungssignale, erst danach interne Links und Sitemap, wie es Seitenreport als praktischen Prüfpfad beschreibt.
Self-referencing Canonicals gelten als Best Practice, denn sie verhindern, dass Tracking-Parameter unbeabsichtigt neue, indexierbare URLs erzeugen, wie SISTRIX erklärt. Jede Seite sollte also standardmäßig auf sich selbst als Canonical verweisen, auch ohne erkennbares Duplicate-Content-Problem.
Für eine Website, die bereits strukturelle SEO-Grundlagen umgesetzt hat, lohnt sich ergänzend ein Blick in unseren Praxis-Guide mit Checkliste, der weitere Prüfpunkte jenseits von Duplicate Content behandelt.
WordPress-konkrete Umsetzung: Permalinks, Plugins und Einstellungen
In WordPress lassen sich die meisten Ursachen mit wenigen gezielten Einstellungen entschärfen. Der erste Schritt betrifft die Permalink-Struktur: Stellen Sie sie unter “Einstellungen” auf “Beitragsname” um, denn Standard-URLs mit Datums- oder Parameterangaben begünstigen Duplikate deutlich stärker.
Die folgenden Punkte gehören in jedes WordPress-Setup:
- Self-referencing Canonicals als Standard, damit jede Seite auf ihre eigene, bevorzugte URL verweist.
- SEO-Plugins wie Yoast, Rank Math oder SEOPress korrekt konfigurieren, inklusive Kontrolle, ob Canonical- und Noindex-Einstellungen sich nicht gegenseitig widersprechen.
- Das Plugin Canonical Pages für die Feinsteuerung einzelner Seiten nutzen, wenn eine Seite ein individuelles Canonical-Ziel benötigt, das vom Standardverhalten abweicht.
- Bei WooCommerce-Shops Filter-URLs, Paginierung und PDF-Dokumente gezielt über x-robots-tag oder HTTP-Header steuern, da sich PDFs nicht per HTML-Canonical beeinflussen lassen.
Gerade bei SEO-Plugins passiert es häufig, dass zwei Plugins gleichzeitig Canonical-Tags setzen oder sich widersprechende Noindex-Regeln aktivieren. Prüfen Sie nach jeder Plugin-Installation den Quellcode stichprobenartig.
Profi-Tipp: Deaktivieren Sie bei einem Plugin-Wechsel immer zuerst die Canonical-Funktion des alten Plugins, bevor Sie das neue aktivieren, sonst können kurzzeitig zwei Canonical-Tags im Quellcode landen.
Wer tiefer in die technische SEO-Konfiguration von WordPress einsteigen möchte, findet ergänzende Hinweise in unserer Anleitung für bessere Sichtbarkeit.
Wie wir Sie bei Audit, Fix und laufender Wartung unterstützen
Ein Duplicate-Content-Problem zu erkennen ist das eine, es sauber und dauerhaft zu beheben das andere. Wir übernehmen für Websitebetreiber beide Schritte: die technische Diagnose und die anschließende Umsetzung.
Unser Vorgehen gliedert sich typischerweise so:
- Audit: Wir identifizieren Canonical-Fehler, fehlerhafte Redirects und Indexierungsprobleme anhand von Quellcode-Prüfung, Server-Logs und Search-Console-Daten.
- Umsetzung: Wir setzen Redirects korrekt, konsolidieren Canonical-Signale, konfigurieren SEO-Plugins passend zur Website-Struktur und richten ein Monitoring ein.
- Laufende Wartung: Über Wartungspakete behalten wir Search-Console-Meldungen im Blick, damit neue Duplikate frühzeitig auffallen.
| Leistungsschritt | Ergebnis für Ihre Website |
|---|---|
| Audit | Klare Liste erkannter Canonical-, Redirect- und Indexierungsfehler |
| Umsetzung | Konsolidierte Signale, korrekt konfigurierte Plugins |
| Wartung | Fortlaufende Search-Console-Überwachung |
Mit über 14 Jahren Erfahrung in der WordPress- und WooCommerce-Entwicklung kennen wir die typischen Stolperfallen, die in gewachsenen Websites über Jahre entstehen. Wer den technischen Teil nicht selbst übernehmen möchte, findet in unserer WordPress Problemlösung eine passende Anlaufstelle für akute Fälle.
Optimierung von Mehrsprachigkeit und hreflang-Tags in WordPress
Mehrsprachige WordPress-Websites bringen eine eigene Form von Duplicate Content mit sich, wenn Inhalte in verschiedenen Sprachversionen sehr ähnlich aufgebaut sind oder Übersetzungs-Plugins fehlerhafte Verknüpfungen erzeugen. Hreflang-Tags lösen dieses Problem nicht durch Deduplizierung, sondern durch Zuordnung: Sie signalisieren, welche Sprachversion für welche Sprache oder Region bestimmt ist, sodass Google keine der Varianten als Duplikat der anderen behandelt.
Entscheidend ist dabei die Konsistenz der Verweise. Jede Sprachversion sollte auf alle anderen Sprachversionen verweisen, inklusive eines Rückverweises auf sich selbst, und die hreflang-Angaben müssen mit den Canonical-Tags der jeweiligen Seite übereinstimmen. Ein häufiger Fehler entsteht, wenn eine Seite per Canonical auf eine andere Sprachversion verweist, gleichzeitig aber per hreflang als eigenständige Sprachvariante ausgewiesen wird. Dieses widersprüchliche Signal verwirrt die Indexierung eher, als dass es sie klärt.
Mehrsprachigkeits-Plugins übernehmen die technische Generierung der hreflang-Tags meist automatisch, sie ersetzen aber nicht die manuelle Kontrolle. Prüfen Sie nach jeder strukturellen Änderung, etwa beim Hinzufügen einer neuen Sprachversion, ob die Verweise vollständig und wechselseitig korrekt gesetzt sind. Gerade bei Websites mit vielen Unterseiten lohnt sich eine stichprobenartige Prüfung über die Google Search Console, die fehlerhafte hreflang-Verweise explizit ausweist.
Welche Risiken entstehen durch häufige Fehleinstellungen?
Die größten Schäden entstehen nicht durch fehlende Maßnahmen, sondern durch widersprüchliche. Wenn eine Seite gleichzeitig ein Canonical auf eine andere URL und ein Noindex trägt, erhält Google zwei sich ausschließende Anweisungen: Die eine sagt “indexiere diese andere Seite als Referenz”, die andere sagt “indexiere mich gar nicht”. In solchen Fällen entscheidet Google nach eigenen Kriterien, welches Signal es gewichtet, was zu unvorhersehbaren Ergebnissen in der Indexierung führt.
Ein weiteres verbreitetes Risiko sind Canonical-Tags, deren Ziel-URL fehlerhaft ist, etwa weil sie auf eine 404-Seite, eine Weiterleitung oder eine ganz andere Themenseite zeigt. Solche falschen Ziel-URLs entstehen oft durch Copy-Paste-Fehler in Templates oder durch Plugin-Updates, die alte Pfade nicht berücksichtigen. Das Ergebnis: Google ignoriert das Canonical-Tag komplett, weil es keine sinnvolle Referenz erkennt, und wählt stattdessen selbst eine URL aus dem Cluster ähnlicher Seiten aus.
Auch die Kombination aus robots.txt-Sperrung und gleichzeitigem Canonical-Tag gehört zu den klassischen Fehlern. Eine per robots.txt blockierte Seite kann vom Crawler nicht gelesen werden, wodurch das darin enthaltene Canonical-Tag niemals erfasst wird. Die Konsolidierung bleibt dann aus, obwohl der Betreiber glaubt, sie korrekt eingerichtet zu haben. Konsistenz zwischen Statuscode, Canonical, robots-Angaben und interner Verlinkung bleibt daher die wichtigste Voraussetzung für funktionierende Signale.
Besondere Herausforderungen bei dynamisch generierten Inhalten
Facettenfilter, wie sie in Shop- und Portalseiten üblich sind, zählen zu den hartnäckigsten Quellen für Duplicate Content, weil sie potenziell unbegrenzt viele URL-Kombinationen erzeugen. Eine Filterkombination aus Farbe, Größe und Preisspanne kann theoretisch Tausende Varianten derselben Produktliste hervorbringen, von denen die meisten nahezu identischen Inhalt zeigen.
Der Umgang damit erfordert eine bewusste Klassifizierung. Filterkombinationen mit eigenständigem Suchvolumen, etwa eine beliebte Kategorie-Farbe-Kombination, können ein eigenes Canonical auf sich selbst erhalten und bleiben indexierbar. Kombinationen ohne eigenständigen Wert, etwa seltene oder zufällige Mehrfachfilter, sollten stattdessen per Canonical auf die übergeordnete, ungefilterte Kategorieseite verweisen oder bei sehr dünnem Inhalt ein Noindex erhalten.
Facettenfilter belasten zusätzlich das Crawl-Budget, weil Suchmaschinen-Bots Zeit auf das Durchsuchen tausender nahezu identischer URLs verwenden, statt neue oder aktualisierte Inhalte zu erfassen. Eine Begrenzung über Parameter-Konventionen, etwa eine feste Reihenfolge der Filterparameter in der URL, reduziert die Zahl der technisch unterschiedlichen, inhaltlich aber identischen Adressen spürbar. Diese Empfehlung deckt sich mit dem allgemeinen Rat, Parameter so weit wie möglich zu standardisieren, den SISTRIX für URL-Parameter generell ausspricht. Wer einen WooCommerce-Shop betreibt, sollte diese Logik von Anfang an in die Filterarchitektur einplanen, statt sie nachträglich zu korrigieren.
Kurzangebot: Duplicate-Content-Check und Wartungspaket
Ein technisches Problem wie doppelte Inhalte lässt sich selten mit einer einzelnen Einstellung lösen, meistens stecken mehrere Ursachen ineinander verschachtelt. Mit unserem kostenlosen SEO Audit erhalten Sie einen ersten Überblick über Canonical-, Redirect- und Indexierungsfehler auf Ihrer Website, bevor Sie entscheiden, wie tief die Korrektur gehen soll.
Für die anschließende Umsetzung bieten wir konkrete Anschlussmöglichkeiten: Über unsere WordPress Wartung behalten wir Search-Console-Meldungen dauerhaft im Blick, sodass neue Duplikate früh auffallen. Bei akuten technischen Fehlern greift unsere WordPress Problemlösung, und wer Duplicate Content als Teil eines größeren Sichtbarkeitsprojekts betrachten möchte, findet in unserer Suchmaschinenoptimierung den passenden Rahmen dafür.
FAQ
Was versteht man unter Duplicate Content in WordPress?
Duplicate Content bezeichnet identische oder sehr ähnliche Inhalte, die unter mehreren URLs derselben Website erreichbar sind, etwa durch Parameter, Protokoll-Varianten oder fehlerhafte Canonical-Tags. Laut SISTRIX zählen diese technischen Ursachen zu den häufigsten Auslösern auf WordPress-Websites.
Wie finde ich Duplicate Content auf meiner Website?
Der zuverlässigste Weg führt über die Google Search Console und ihren Bericht zu Seiten, die als Duplikat ohne vom Nutzer festgelegte kanonische Version eingestuft wurden. Ergänzend hilft eine Quellcode-Prüfung zentraler Seiten, um zu kontrollieren, ob Canonical-Tag und Statuscode zusammenpassen.
Reicht ein Canonical-Tag immer aus, um Duplicate Content zu beheben?
Nein, ein Canonical-Tag ist eine Empfehlung an Google, kein verbindlicher Schalter. Laut Seitenreport müssen Statuscode, interne Links und Sitemap-Einträge mit der Canonical-Angabe übereinstimmen, sonst wird sie ignoriert, und bei dauerhaften URL-Änderungen ist ein 301-Redirect die robustere Lösung.
Welche Rolle spielen SEO-Plugins bei der Behebung von Duplicate Content?
SEO-Plugins wie Yoast, Rank Math oder SEOPress steuern Canonical- und Noindex-Einstellungen direkt im WordPress-Backend und erleichtern dadurch die Korrektur erheblich. Für die Feinsteuerung einzelner Seiten lässt sich zusätzlich das Plugin Canonical Pages einsetzen, das individuelle Canonical-Ziele pro Seite erlaubt.
Kann robots.txt Duplicate Content verhindern?
Robots.txt blockiert lediglich das Crawling einer Seite, ersetzt aber kein Noindex oder Canonical, denn eine blockierte Seite kann vom Crawler gar nicht auf ihre Meta-Angaben geprüft werden. Für die Konsolidierung von Duplikaten sind Canonical-Tags, Redirects oder Noindex die geeigneteren Werkzeuge.
Quellen
- Duplicate Content: Doppelte Inhalte vermeiden – SISTRIX
- Canonical Tag: typische Fehler, Beispiele und Best Practices | Seitenreport
- Canonical Pages – WordPress.org
